
과학 연구 AI 벤치마크, GPT-6 아스트라 63%·클로드 오퍼스 5.5 62% (2026)
아티피셜 애널리시스(@ArtificialAnlys)는 9월 24일 과학 연구용 에이전트 벤치마크 ‘Terminal-Bench-Science 0.1’ 리더보드를 공개했습니다. GPT-6 아스트라(max)가 63%, 클로드 오퍼스 5.5(xhigh)가 62%로 선두입니다.
벤치마크 구성
이 벤치마크는 2026년 8월 발표됐으며 생명·물리·수학·공학·지구 과학 5개 분야의 전문가 선별 과제 70개로 구성됩니다. 에이전트가 샌드박스 환경에서 과제를 처음부터 끝까지 수행하고, 3회 시도의 평균 pass@1로 점수를 매깁니다.
모델별 결과
50% 이상을 기록한 모델은 GPT-6 아스트라와 클로드 오퍼스 5.5 두 개뿐입니다. 클로드 오퍼스 5.5는 수학 과학 과제의 71%를 통과했지만 생명 과학 과제는 46%만 통과했습니다.
오픈 웨이트 모델
최고 오픈 웨이트 모델인 GLM-5.3(max)은 10%, DeepSeek V4.1 Flash(max)는 9%를 기록했습니다. 선두 모델과의 격차는 50%포인트 이상입니다.
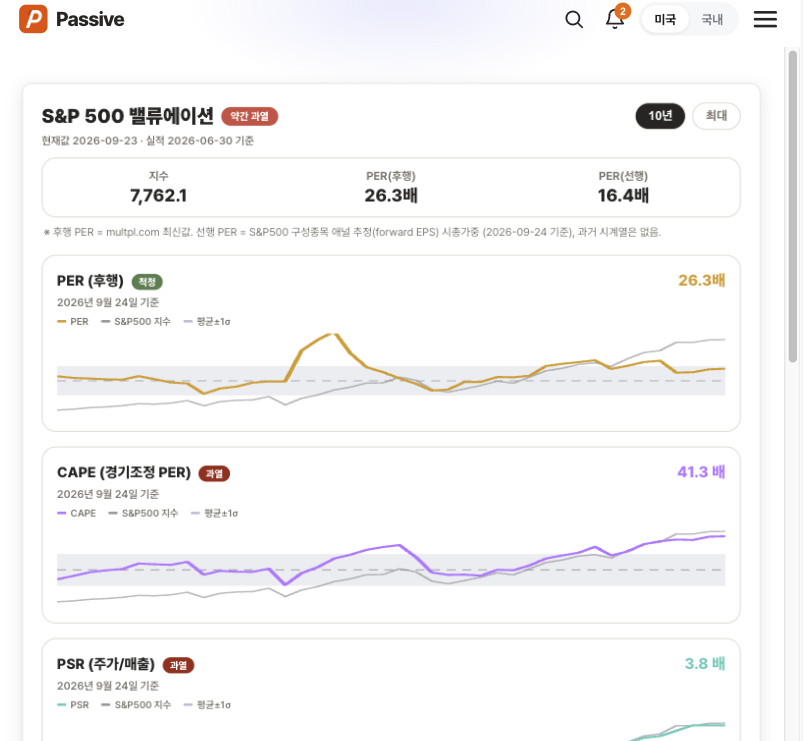
지수 밸류에이션 화면으로 보기
Passive 지수 밸류에이션 미국 화면에서 S&P500 지수는 7,762.1로 ‘약간 과열’로 표시됩니다. 후행 PER은 26.3배, 선행 PER은 16.4배, CAPE는 41.3배입니다.
본 글은 투자자문이 아니며 특정 종목의 매수·매도를 권유하지 않습니다. 투자 판단과 책임은 본인에게 있습니다.